바로 받기
 Semiconductor AI & Coding Bootcamp학습 시작
SECOM Semiconductor Manufacturing Process
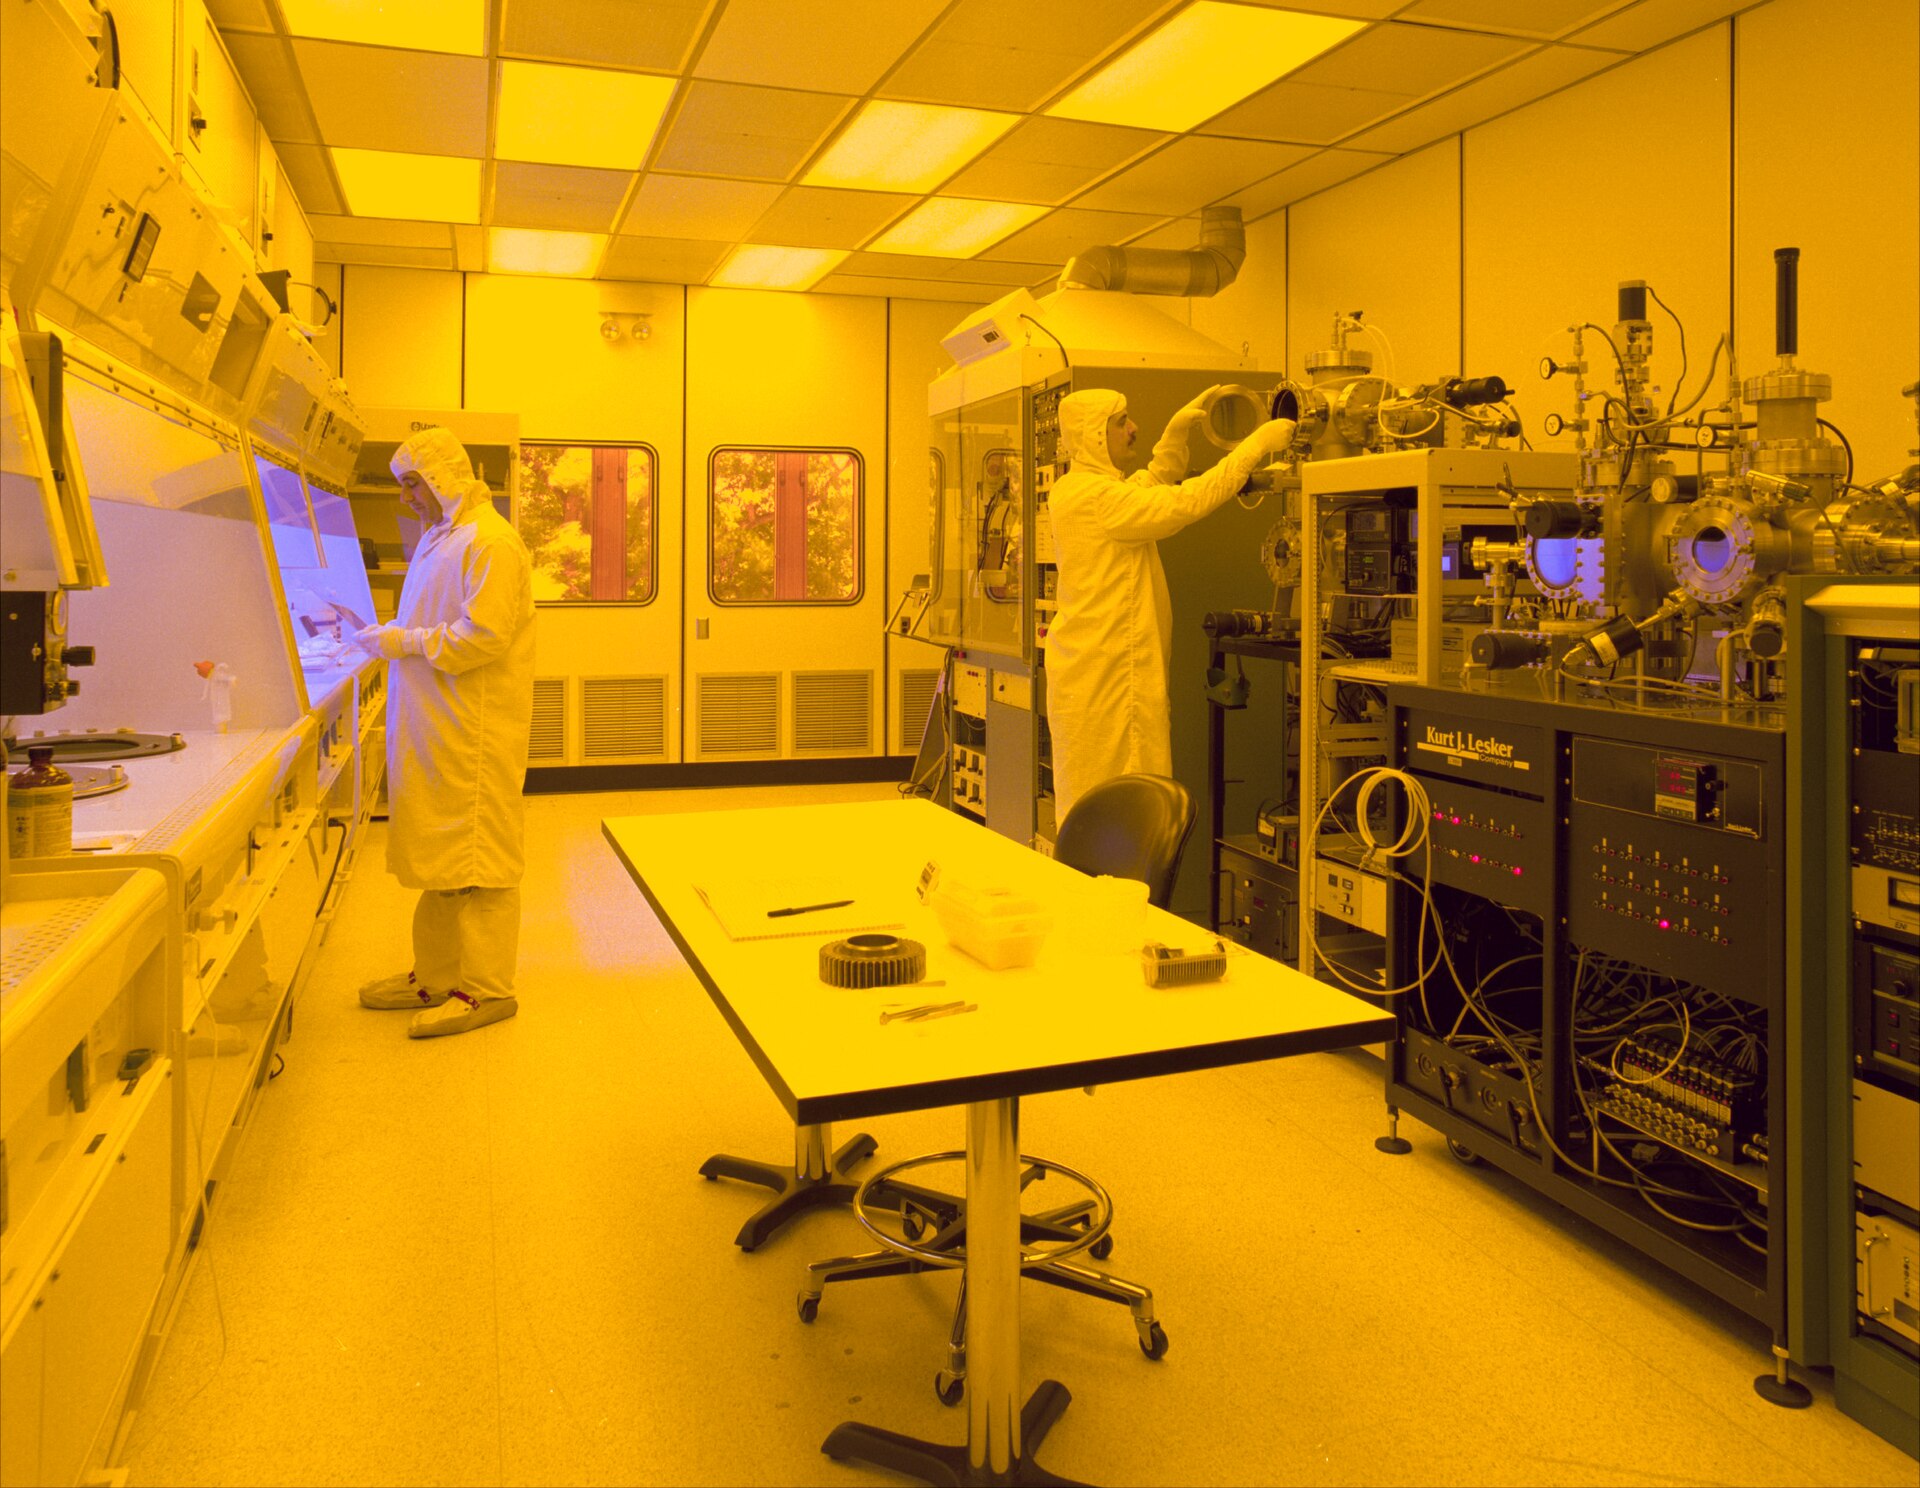
반도체 생산 라인의 센서 590개를 한 줄로 찍은 1,567개 런. 어떤 런이 불량으로 끝날지 맞히는 문제.
실제 반도체 생산 라인에서 런 하나마다 590개 센서 값을 기록하고 그 런이 최종 검사에서 통과했는지(pass) 떨어졌는지(fail)를 붙여 놓은 데이터입니다. 센서가 590개나 되지만 대부분은 결과와 무관한 잡음이라 어떤 센서가 실제로 수율을 좌우하는지 골라내는 특징 선택(feature selection) 문제의 교과서로 쓰입니다.
불량이 전체의 6.6%뿐이라 클래스 불균형도 함께 다뤄야 합니다. 전부 정상이라고 찍어도 정확도 93%가 나오기 때문에, 정확도만 보면 아무것도 못 배운 모델을 좋은 모델로 착각하게 됩니다.
sensor_001 … sensor_590pass_failtimestamp아래 코드를 붙여 넣으면 SECOM 반도체 공정 센서 데이터을 내려받지 않고 바로 불러옵니다. SemiLab 노트북에서는 상단 「데이터」 버튼으로 같은 셀을 넣을 수도 있습니다.
내 프로젝트의 Jupyter 노트북. 파일이 이미 datasets/ 폴더에 있어 이름만 적습니다.
import pandas as pd

df = pd.read_csv("datasets/secom.csv")

print(df.shape)
df.head()
파일 주소: /dataset-files/secom/secom.csv
센서 590개 가운데 결측이 심하거나 값이 늘 똑같은 것을 걸러내고 실제로 남는 센서가 몇 개인지 세어 본다.
완료 기준 「590개 중 N개가 남았고 이유는 이렇다」를 숫자와 그래프로 말할 수 있으면 완료.
pandasmatplotlib
전부 정상이라고 찍는 모델이 정확도 93.4%를 낸다는 걸 직접 확인하고 그보다 실제로 쓸모 있는 모델을 만든다.
완료 기준 「정확도는 떨어졌지만 불량을 N배 더 잡는다」를 표로 보여주고 그 교환이 왜 타당한지 설명할 수 있으면 완료.
scikit-learnpandasmatplotlib
불량을 놓쳤을 때(FN)와 정상을 불량이라 했을 때(FP)의 비용을 다르게 두고 총비용이 가장 낮은 임계값을 찾는다.
완료 기준 비용 가정이 바뀌면 답도 바뀐다는 걸 곡선으로 보여줄 수 있으면 완료.
scikit-learn